반복성 표준편차 s_r은 ‘반복성 조건에서 얻은 결과가 얼마나 흩어지는가’라는 측정 대상(개념)이다. 합동 표준편차 s_p는 여러 그룹의 분산을 자유도 가중으로 합치는 계산 방법이다. 둘은 다른 층위의 말이다. 여러 그룹이 각각 반복성 조건에서 얻어졌고 그룹 간 분산이 같다고 볼 수 있으면 s_p=√[Σ(n_i−1)s_i²/Σ(n_i−1)]가 s_r의 가장 안정적인 추정값이 되고, 자유도는 N−k로 적는다. 그룹이 하나뿐이면 그 그룹의 s가 곧 s_r 추정값이다. 그룹 안에서 조건이 바뀌었거나 그룹 간 분산이 다르면 합치지 말고 그룹별로 보고한다. 불확도 예산에서 s_r(또는 s_p)은 반복성 성분일 뿐이므로, 결과가 여러 날에 걸쳐 나오면 날간 성분을 따로 넣어야 한다.
목차
같은 숫자가 될 수는 있지만 같은 말은 아니다
보고서 양식에 '반복성 표준편차' 칸이 있고, 손에 쥔 자료는 여러 배치에서 반복 측정한 QC 값이다. 이때 '합동 표준편차를 넣어야 하나, 반복성 표준편차를 넣어야 하나'라고 묻는 것은 사실 두 질문이 섞인 것이다.
– 반복성 표준편차 s_r은 *무엇을 재는가*에 대한 이름이다. 같은 절차, 같은 분석자, 같은 측정 시스템으로 짧은 기간 안에 반복한 결과의 산포를 가리킨다.
– 합동 표준편차 s_p는 *어떻게 구하는가*에 대한 이름이다. 여러 그룹의 분산을 각 그룹의 자유도로 가중 평균한 뒤 제곱근을 취하는 계산법이다.
그래서 둘은 대립하는 선택지가 아니다. 각 그룹이 반복성 조건에서 얻어진 자료라면, 합동 계산은 s_r을 추정하는 방법 중 하나이고 그룹이 여럿일 때 가장 안정적인 방법이다. 보고서에는 '반복성 표준편차(여러 그룹의 합동 추정)'처럼 개념과 계산법을 함께 적으면 된다.
| 구분 | 반복성 표준편차 s_r | 합동 표준편차 s_p |
|---|---|---|
| 성격 | 개념: 어떤 조건에서의 산포인가 | 계산 방법: 여러 그룹의 분산을 어떻게 합치나 |
| 근거 | VIM 2.20·2.21, ISO 5725 계열의 정밀도 용어 | 자유도 가중 평균 분산(분산분석의 그룹 내 평균제곱과 같음) |
| 전제 | 같은 절차·분석자·측정 시스템·운영 조건·장소, 짧은 기간의 반복 | 각 그룹의 분산이 같은 모분산을 추정한다는 가정(등분산) |
| 그룹이 하나일 때 | 그 그룹의 표본표준편차 s(자유도 n−1) | 계산할 필요가 없다. s와 같다 |
| 그룹이 여럿일 때 | s_p로 추정하는 것이 일반적 | √[Σ(n_i−1)s_i²/Σ(n_i−1)], 자유도 N−k |
| 담지 않는 것 | 날간·분석자 간·실험실 간 변동 | 그룹 평균끼리의 차이(배치 간·날간 변동) |
표의 마지막 줄이 실무에서 가장 자주 놓치는 부분이다. 합동 계산은 그룹 평균의 차이를 버리고 그룹 안의 흩어짐만 모은다. 따라서 날짜별 그룹으로 합동 표준편차를 구해도 그 값은 날간 변동을 포함하지 않는 반복성 추정값이다.
반복성은 조건으로 정의된다
국제측정학용어집(VIM, JCGM 200)은 측정 정밀도를 '지정된 조건에서 같거나 비슷한 대상을 반복 측정해 얻은 지시값 또는 측정값 사이의 일치 정도'로 정의하고, 보통 그 조건에서의 표준편차·분산·변동계수 같은 부정밀도 척도로 수치화한다고 적는다. 여기서 '지정된 조건'의 예로 반복성 조건, 중간정밀도 조건, 재현성 조건을 들며 ISO 5725-1을 참조한다.
반복성 조건은 같은 측정 절차, 같은 운영자, 같은 측정 시스템, 같은 운영 조건, 같은 장소에서 짧은 기간 동안 같거나 비슷한 대상을 반복 측정하는 조건이다. 측정 반복성은 이 조건에서의 측정 정밀도다. VIM은 또 '어떤 측정 조건이 반복성 조건인지는 지정한 반복성 조건의 집합에 대해서만 말할 수 있다'고 덧붙인다.
이 정의에서 두 가지가 나온다.
1. s_r이라는 이름을 붙이려면 먼저 각 그룹 안의 반복이 반복성 조건이었는지를 확인해야 한다. 한 '배치' 안에서 재교정을 했거나 시약 로트를 바꿨거나 분석자가 교대했다면, 그 배치의 표준편차는 반복성보다 넓은 조건의 산포다.
2. 반복성 조건을 실험실이 지정해야 한다. 같은 날 같은 교정곡선으로 측정한 반복을 반복성 조건으로 정했다면, 그 정의를 검증 기록에 적어 둔다. 그래야 나중에 그 s_r을 불확도 예산에 넣을 때 어떤 변동이 빠져 있는지 알 수 있다.
개념이 조건으로 정해지므로, 같은 반복성 조건의 자료라면 그룹 하나에서 구하든 여러 그룹에서 합쳐 구하든 추정하려는 대상은 같다. 달라지는 것은 추정값의 안정성, 곧 자유도다.
합동 계산은 반복성 조건의 그룹 여러 개를 하나의 추정값으로 묶는다
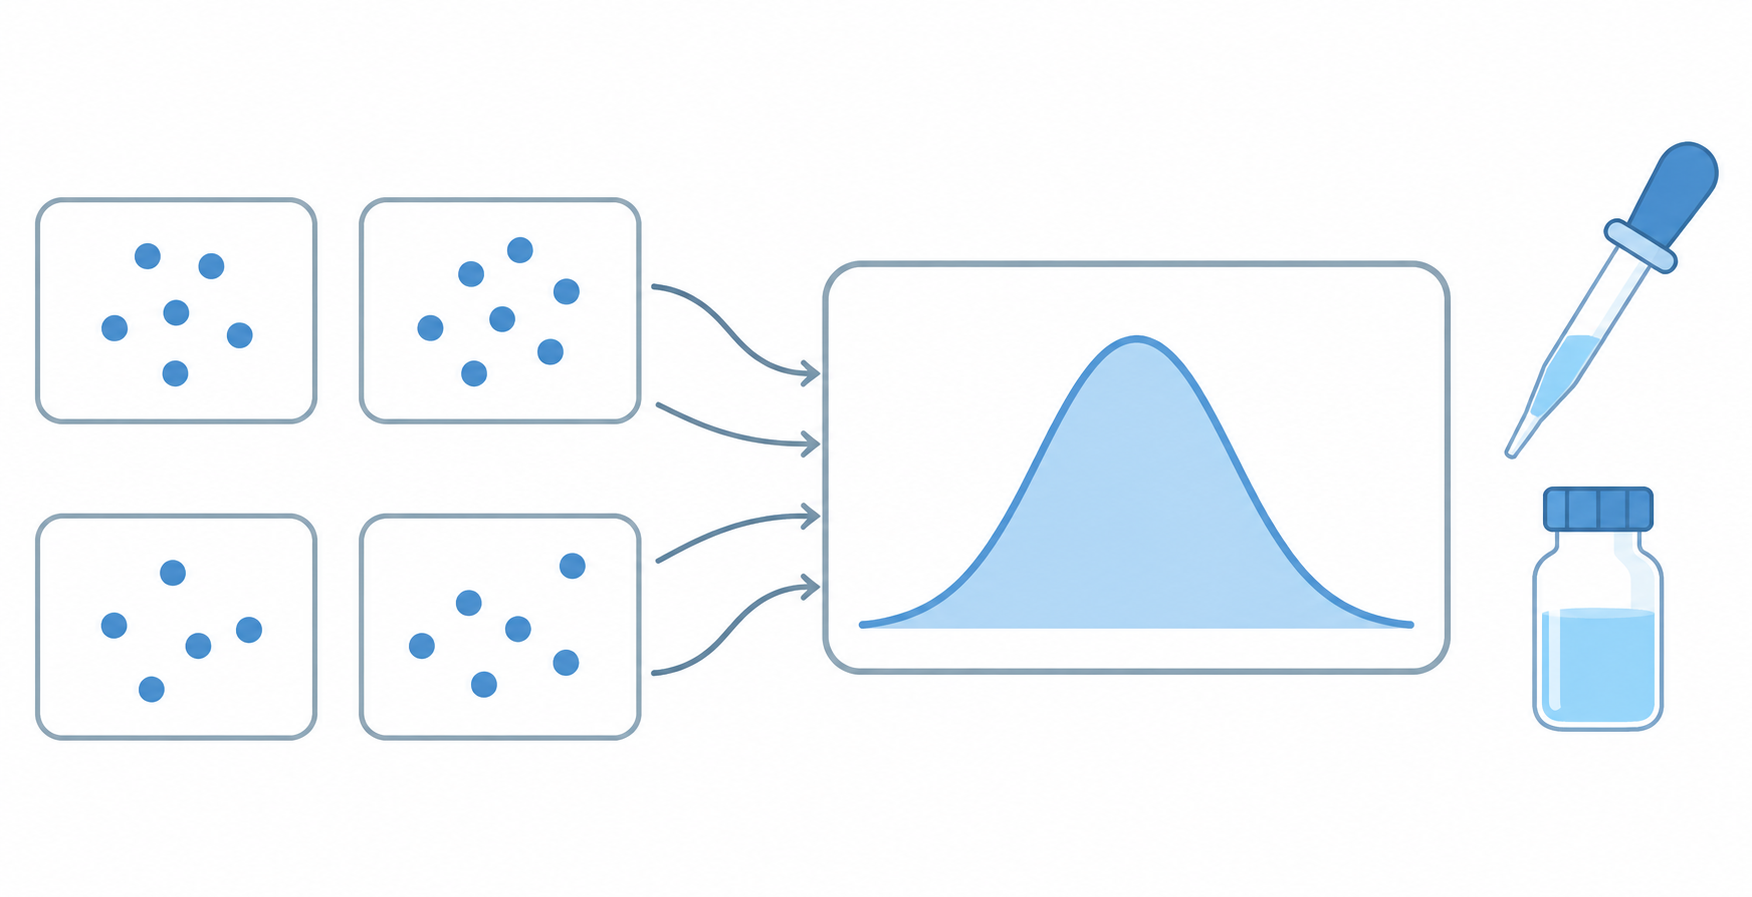
NIST/SEMATECH e-Handbook of Statistical Methods는 반복 측정 J회로 이루어진 각 그룹마다 반복성(level-1) 표준편차를 구한 뒤, 적절한 경우 날·런·체크 표준에 걸쳐 이 표준편차들을 합동하면 더 신뢰할 만한 정밀도 척도가 된다고 설명한다. 합동 반복성 표준편차는 각 그룹의 제곱합(자유도×분산)을 더해 전체 자유도로 나눈 값의 제곱근이며, J회 반복·K일·L런 설계라면 자유도는 LK(J−1)이다.
그룹마다 반복 횟수가 다르면 일반식은 다음과 같다.
s_p² = Σ(n_i − 1)s_i² / Σ(n_i − 1) = Σ(n_i − 1)s_i² / (N − k)
여기서 k는 그룹 수, N은 전체 측정값 수다. 같은 식이 Bartlett 등분산 검정에서 합동 분산의 정의로도 쓰인다. 단계별 계산과 배치 간 분산까지 함께 구하는 절차는 여러 배치 QC 데이터의 표준편차는 어떻게 합치나에 정리했으므로, 이 글에서는 판단에 필요한 성질만 짚는다.
– 표준편차를 단순 평균하지 않는다. 분산을 자유도로 가중해 합친 뒤 제곱근을 취한다. 반복 수가 다른 그룹을 단순 평균하면 적은 반복으로 얻은 불안정한 s에 같은 비중이 실린다.
– 반복이 1회뿐인 그룹은 기여하지 않는다. n_i−1=0이므로 분자와 분모 어디에도 들어가지 않는다. 이런 자료는 이 글의 범위 밖이다.
– 자유도가 커지는 것이 합동의 이득이다. 그룹 하나의 s는 자유도가 n−1에 머물지만, 같은 조건의 그룹을 모으면 N−k로 늘어난다. 자유도는 불확도 예산에서 유효자유도와 포함인자를 정할 때 다시 쓰이므로 반드시 함께 적는다.
– 그룹 평균의 차이는 버려진다. 그래서 s_p는 그룹 안의 반복성만 나타낸다. 그룹 간 변동을 분리해 추정하는 방법은 반복성·날간·중간정밀도를 분산분석으로 나누는 글을 본다.
– 분모가 n−1(합동이면 N−k)인 이유는 표준편차는 n−1로 나누나 n으로 나누나에서 다뤘다.
합쳐도 되는지 판단하는 순서
합동 표준편차를 s_r로 쓰기 전에 아래 순서로 확인한다. 앞 단계에서 걸리면 뒤 단계로 가지 않는다.
1단계: 각 그룹이 반복성 조건이었나. 그룹 하나 안에서 재교정, 표준용액·시약 로트 교체, 분석자 교대, 장비 정비가 있었다면 그 그룹은 반복성 조건이 아니다. 그 그룹을 빼거나 그 시점에서 그룹을 나눈다.
2단계: 그룹들이 같은 측정 대상을 겨누나. 같은 시험법, 같은 매질의 QC 품목 또는 같은 시료, 비슷한 농도 수준이어야 한다. 그룹 평균 수준이 크게 달라 산포가 평균에 비례해 커지는 자료는 표준편차가 아니라 RSD로 합치는 별도 처리가 필요하며, 이 글의 범위 밖이다.
3단계: 그룹 간 분산이 같다고 볼 수 있나. 합동 계산은 모든 그룹이 같은 모분산을 추정한다는 가정 위에 있다. 이를 확인하는 대표 검정은 다음과 같다.
– Bartlett 검정: k개 표본의 분산이 같은지를 검정한다. 검정통계량 T가 자유도 k−1인 카이제곱 분포의 상측 임계값보다 크면 분산이 같지 않다고 판단한다. 다만 정규성에서 벗어나는 데 민감해서, 자료가 정규분포가 아니면 등분산이 아니라 비정규성을 검정하는 셈이 될 수 있다.
– Levene 검정: Bartlett 검정의 대안으로 정규성 이탈에 덜 민감하다. 중앙값을 쓰는 형태가 여러 비정규 자료에서 견고하다.
– 협동 실험의 정밀도 산출에서 쓰는 Cochran 검정처럼 가장 큰 분산이 튀는지를 보는 방법도 있다. 어떤 검정을 쓸지는 시험법이나 실험실 절차에서 정한 방법을 따른다.
검정 결과를 읽을 때 주의할 점이 있다. 그룹 수와 그룹당 반복이 적으면 검정력이 낮아서 '유의하지 않음'이 '분산이 같음'의 증명이 되지 않는다. 검정과 함께 그룹별 s_i를 나란히 놓고, 유독 큰 그룹이 있으면 그 그룹에서 무엇이 달랐는지(분석자, 장비, 시료 전처리)를 기록에서 찾는다. 원인이 확인되면 검정 결과와 관계없이 그 그룹은 같은 조건이 아니다.
4단계: 결정과 기록.
– 세 조건을 모두 통과하면 s_p를 s_r의 추정값으로 쓰고 자유도 N−k를 적는다.
– 그룹이 하나뿐이면 그 그룹의 s를 s_r 추정값으로 쓰고 자유도 n−1을 적는다.
– 분산이 다르거나 조건이 바뀐 그룹이 있으면 합치지 않는다. 그룹별 s와 자유도를 따로 보고하고, 어느 조건의 값을 불확도 예산에 쓸지는 실제 시료를 측정하는 조건에 맞춰 정한다.
계산 예시: 4개 배치 QC 자료 (가상 교육용 데이터)
아래 값은 판단 흐름을 보이기 위한 가상(교육용) 데이터이며 실제 측정 결과가 아니다. 같은 QC 품목(단위 mg/L)을 4개 배치에서 각각 3~5회 반복 측정했고, 각 배치 안의 반복은 같은 날, 같은 교정곡선, 같은 분석자로 수행했다고 가정한다(1·2단계 통과).
– 배치 A: 10.2, 10.5, 10.1, 10.4 (n=4)
– 배치 B: 10.3, 10.6, 10.2, 10.5, 10.4 (n=5)
– 배치 C: 10.0, 10.4, 10.3 (n=3)
– 배치 D: 10.6, 10.3, 10.5, 10.2 (n=4)
배치별 표본표준편차(n−1)는 A 0.183, B 0.158, C 0.208, D 0.183 mg/L로 0.158~0.208 mg/L 범위다.
등분산 확인(3단계). 배치 내 제곱합은 A 0.1000, B 0.1000, C 0.0867, D 0.1000으로 합계 0.3867, 자유도 합계는 3+4+2+3=12다. 합동 분산 s_p²=0.3867/12=0.03222이다. 이 값으로 Bartlett 검정통계량을 계산하면 T≈0.19이고, 자유도 k−1=3인 카이제곱 분포의 0.95 분위수 7.815보다 훨씬 작다. 분산이 다르다는 근거는 없다. 다만 자유도가 작아 검정력이 낮다는 점을 감안해 배치별 s를 다시 보면, 배치 C가 가장 크지만 반복이 3회(자유도 2)라 표본 변동 범위 안으로 볼 수 있고 C에서 조건이 달랐다는 기록도 없다고 가정한다.
결정(4단계). 합동 표준편차 s_p=√0.03222≈0.180 mg/L를 반복성 표준편차의 추정값으로 쓰고, 자유도는 N−k=16−4=12로 적는다.
참고로 배치별 s를 단순 평균하면 0.183 mg/L이 나온다. 이 예에서는 차이가 작지만, 반복 수가 크게 다르거나 반복이 적은 배치의 s가 튀면 차이가 커진다. 단순 평균에는 정해진 자유도도 붙일 수 없다.
검증 기록에는 예를 들어 이렇게 남긴다.
> 반복성 표준편차 s_r = 0.180 mg/L (4개 배치 합동 추정, N=16, 자유도 12). 반복성 조건: 같은 날·같은 교정곡선·같은 분석자. 등분산: Bartlett T=0.19, χ²(0.95; 3)=7.815, 분산이 다르다는 근거 없음. 배치 간 변동은 이 값에 포함되지 않음.
보고서와 불확도 예산에는 어떻게 적나
방법 검증 기록. 반복성 값 하나만 적으면 나중에 그 값이 무엇을 담았는지 알 수 없다. 최소한 다음을 함께 적는다: 추정 방법(단일 그룹 s 또는 합동 s_p), 그룹 수 k와 전체 측정 수 N, 자유도(n−1 또는 N−k), 실험실이 지정한 반복성 조건, 등분산 확인 방법과 결과, 제외한 그룹과 그 사유. 시험법이나 고객 요구에 반복성 허용 기준이 있으면 그 기준과 비교한 판정도 같은 기록에 남긴다. 허용 기준 자체는 시험법·규격마다 다르므로 그 문서를 따른다.
불확도 예산의 반복성 성분. NIST TN 1297은 Type A 평가가 통계적으로 타당한 어떤 방법에도 근거할 수 있다고 하며, 독립 관측 계열의 평균의 표준편차를 구하는 것과 분산분석으로 임의 효과를 정량하는 것을 예로 든다. 합동 s_p는 이 Type A 평가에 쓸 수 있는 안정적인 추정값이다. 보고 결과가 n회 독립 반복 측정의 평균이면 반복성 성분은 s_p/√n이고, 단일 측정값을 보고하면 s_p 자체다. 위 예시에서 실제 시료를 2회 반복 측정해 평균을 보고한다면 반복성 성분은 0.180/√2≈0.127 mg/L이고 자유도는 s_p를 구한 자유도 12를 그대로 적는다. 이 값은 반복성 성분 하나만 보인 부분 예시이며, 교정·CRM·날간 변동 등 다른 성분은 별도로 평가해 합성해야 한다. ±값 옆에 SD인지 SE인지 밝히는 문제는 표준편차와 표준오차, 정도관리에서는 언제 쓰나를, 반복값 표준불확도 계산의 세부는 측정 반복값 표준불확도 계산법을 본다.
s_r만으로 부족한 경우. NIST/SEMATECH e-Handbook은 시험 품목에 대한 반복 측정이 대개 측정 과정의 날간 변화를 포착할 만큼 긴 기간을 덮지 못한다고 지적한다. 실제 시료가 여러 날, 여러 교정곡선에 걸쳐 측정된다면 s_r(합동이든 아니든)만 불확도 예산에 넣으면 날간 성분이 빠진다. 이 경우에는 날짜×반복 자료를 분산분석으로 나눠 중간정밀도를 구하거나, 장기 QC 자료의 날간 산포를 별도 성분으로 넣는다. Eurachem의 방법 검증 가이드(The Fitness for Purpose of Analytical Methods, 3판 2025)도 정밀도 연구를 위한 분산분석을 부록에서 다룬다.
ISO/IEC 17025와의 연결. 인정기관 Perry Johnson Laboratory Accreditation의 해설에 따르면 ISO/IEC 17025:2017 7.6은 측정불확도에 대한 유의한 기여 요소를 식별하고 적절한 방법으로 평가하도록 요구하며, 엄밀한 평가가 불가능하면 이론이나 경험에 근거한 합리적 추정이 필요하다. 반복성 성분이 어떤 조건의 산포인지, 어떻게 추정했는지를 적어 두면 다른 성분과 중복되거나 빠진 것이 없는지 심사 때 바로 설명할 수 있다.
적용 전 점검표
– [ ] 각 그룹 안의 반복이 실험실이 지정한 반복성 조건(같은 절차·분석자·측정 시스템·운영 조건·장소, 짧은 기간)에서 얻어졌다.
– [ ] 그룹 안에서 재교정, 로트 교체, 분석자 교대, 장비 정비가 없었다. 있었다면 그 시점에서 그룹을 나눴다.
– [ ] 모든 그룹이 같은 시험법, 같은 매질, 비슷한 농도 수준이다.
– [ ] 등분산을 시험법·실험실 절차에서 정한 방법(예: Bartlett, Levene)으로 확인했고, 정규성 가정과 검정력 한계를 함께 고려했다.
– [ ] 유독 큰 s_i를 보인 그룹의 원인을 기록에서 확인했다.
– [ ] 합쳤다면 s_p와 자유도 N−k를, 합치지 않았다면 그룹별 s와 자유도 n_i−1을 적었다.
– [ ] 표준편차를 단순 평균하지 않고 분산을 자유도로 가중해 합쳤다.
– [ ] 불확도 예산에서 결과가 n회 반복 평균일 때만 반복성 성분을 √n으로 나눴다.
– [ ] 실제 시료가 여러 날에 걸쳐 측정되면 날간(중간정밀도) 성분을 따로 넣었다.
이어서 볼 글: 여러 배치 QC 데이터의 표준편차는 어떻게 합치나 — 합동 표준편차와 배치 간 분산 계산
근거 자료
- JCGM 200 국제측정학용어집(VIM3) (JCGM 200:2012(VIM3) 온라인판) — 2.20 repeatability condition of measurement, NOTE 1
- JCGM 200 국제측정학용어집(VIM3) (JCGM 200:2012(VIM3) 온라인판, 2014-12-01 주석 포함) — 2.21 measurement repeatability
- JCGM 200 국제측정학용어집(VIM3) (JCGM 200:2012(VIM3) 온라인판) — 2.15 measurement precision, NOTE 1·NOTE 2
- NIST/SEMATECH e-Handbook of Statistical Methods (온라인판(확인일 2026-11-02)) — 1.3.5.7 Bartlett’s Test, Test Statistic·Significance
- NIST/SEMATECH e-Handbook of Statistical Methods (온라인판(확인일 2026-11-02)) — 1.3.6.7.4 Critical Values of the Chi-Square Distribution, upper-tail table ν=3, 0.95 열
- Perry Johnson Laboratory Accreditation, ISO/IEC 17025 7.6·7.7 해설 (ISO/IEC 17025:2017 기준 해설 페이지) — Clause 7.6 Evaluation of Measurement Uncertainty 설명
- NIST/SEMATECH e-Handbook 2.4.4.1 Analysis of repeatability
- NIST/SEMATECH e-Handbook 2.4.4.4 Example of calculations (pooled repeatability)
- NIST/SEMATECH e-Handbook 1.3.5.10 Levene Test for Equality of Variances
- NIST/SEMATECH e-Handbook 2.5.3.1.1 Type A evaluations of time-dependent effects
- NIST TN 1297: 3. Type A Evaluation of Standard Uncertainty
- Eurachem: The Fitness for Purpose of Analytical Methods (2025, 3rd edition)